Elevando o Apache Spark: Controle PID Adaptativo e Modelagem Matemática em Sistemas Distribuídos
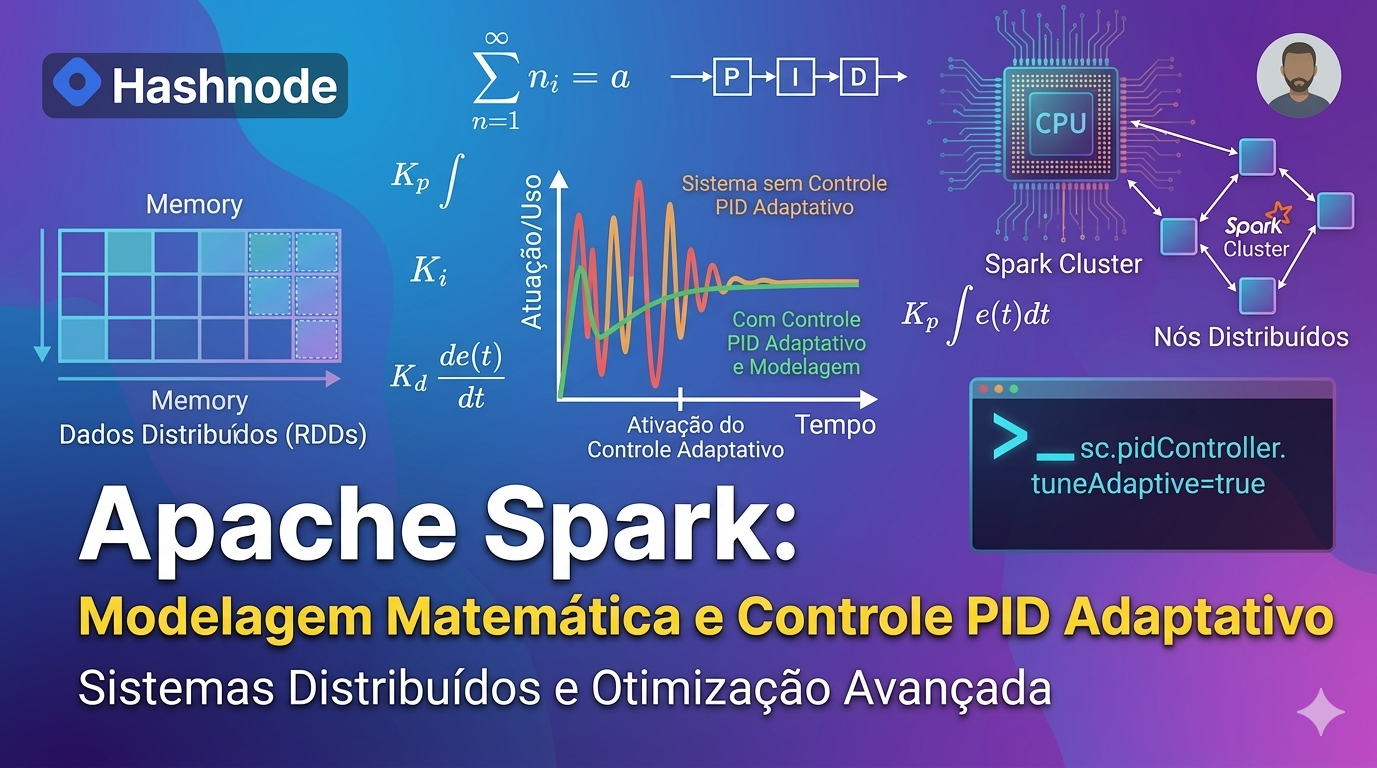
Introdução A ingestão massiva de dados em bancos de dados relacionais via Apache Spark frequentemente esbarra em gargalos catastróficos, como saturação de rede e Data Skew. Embora mecanismos tradicion
#performance-optimization#apache-spark-distributed-systems-scala-control-theory-software-architecture
Responses
Markdown supported · ⌘↵ to post
No responses yet.